



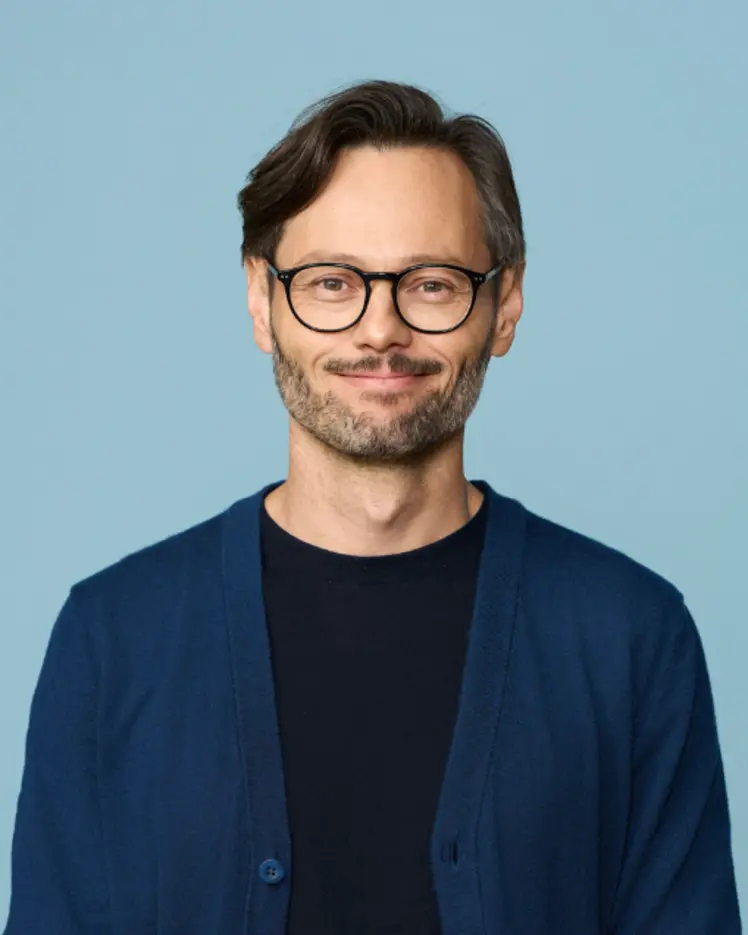
Hugo Larochelle
Biographie
Hugo Larochelle est le directeur scientifique de Mila, l’un des plus importants centres de recherche en intelligence artificielle au monde. Avec une communauté de près de 2000 chercheurs et professionnels, l’institut s’est imposé comme un pilier de l'écosystème canadien de l’IA, avec un rayonnement qui s’étend bien au-delà des frontières du pays.
En tant que chercheur pionnier et leader industriel, il possède une connaissance unique tant sur les grands laboratoires de recherche en entreprise que sur l’excellence de la communauté universitaire canadienne en IA. Il a bâti ses assises académiques auprès de deux des « pères fondateurs » de l'intelligence artificielle : Yoshua Bengio et Geoffrey Hinton.
Au fil des ans, ses recherches ont mené à plusieurs découvertes que l'on retrouve dans les systèmes d'IA modernes. Ses travaux sur les auto-encodeurs débruiteurs (DAE) ont établi la reconstruction de données pures à partir de versions corrompues comme un paradigme évolutif pour l'apprentissage de représentations significatives à partir de grandes quantités de données non étiquetées. Grâce à des modèles tels que l'Estimateur de distribution autorégressif neuronal (NADE) et l'Auto-encodeur masqué pour l'estimation de distribution (MADE), il a contribué à populariser la modélisation autorégressive neuronales, désormais omniprésent dans l'IA générative. De plus, ses travaux sur l'apprentissage de nouvelles tâches sans données (Zero-Data Learning of New Tasks) ont introduit le concept, aujourd'hui courant, de l'apprentissage « zero-shot ».
Il a jeté un pont entre le milieu académique et l’industrie en cofondant la startup Whetlab, acquise par Twitter en 2015. Après un passage chez Twitter Cortex, il a été recruté pour diriger le laboratoire de recherche en IA de Google à Montréal (Google Brain), aujourd’hui intégré à Google DeepMind. Il demeure professeur associé à l'Université de Montréal et l’Université McGill, et est titulaire d'une chaire en IA Canada-CIFAR, formant ainsi la relève scientifique.
Parallèlement à ses fonctions de directeur scientifique chez Mila, il est également responsable scientifique chez Adaption Labs et conseille les start-ups Tiptree Systems et Prizmal.
Père de quatre enfants, Hugo Larochelle et sa conjointe, Angèle St-Pierre, ont également fait de multiples dons à l'Université de Montréal et à l'Université de Sherbrooke, particulièrement dans le domaine de l'IA pour l’environnement. Il a également fondé la conférence Techaide, mobilisant la communauté technologique de Montréal afin de collecter des fonds pour Centraide dans sa mission de lutte contre la pauvreté et l'exclusion sociale.