
Les inscriptions sont ouvertes pour notre programme de 4 mois à temps plein, à Mila, conçu spécifiquement pour les fondateurs et fondatrices de la deep tech issus de parcours d'élite en STIM. Vous avez jusqu'au 21 novembre 2026 pour appliquer!

Offert par Mila et le Forum des politiques publiques, ce programme est conçu pour outiller les décideur·euse·s et les responsables des politiques publiques à naviguer efficacement à travers les opportunités et les risques liés à l'IA. La prochaine cohorte se tiendra en anglais les 5 et 6 novembre 2026 à Ottawa.

Le processus de demandes de supervision à Mila est maintenant ouvert! Vous pouvez appliquer dès maintenant à la maitrise de recherche ou Doctorat et joindre notre grande communauté de chercheur·euse·s à Mila pour l’automne 2027. Date limite : 1er décembre 2026
Nous utilisons des témoins pour analyser le trafic et l’utilisation de notre site web, afin de personnaliser votre expérience. Vous pouvez désactiver ces technologies à tout moment, mais cela peut restreindre certaines fonctionnalités du site. Consultez notre Politique de protection de la vie privée pour en savoir plus.
Paramètre des cookies
Vous pouvez activer et désactiver les types de cookies que vous souhaitez accepter. Cependant certains choix que vous ferez pourraient affecter les services proposés sur nos sites (ex : suggestions, annonces personnalisées, etc.).
Cookies essentiels
Ces cookies sont nécessaires au fonctionnement du site et ne peuvent être désactivés. (Toujours actif)
Cookies analyse
Acceptez-vous l'utilisation de cookies pour mesurer l'audience de nos sites ?
Lecteur Multimédia
Acceptez-vous l'utilisation de cookies pour afficher et vous permettre de regarder les contenus vidéo hébergés par nos partenaires (YouTube, etc.) ?
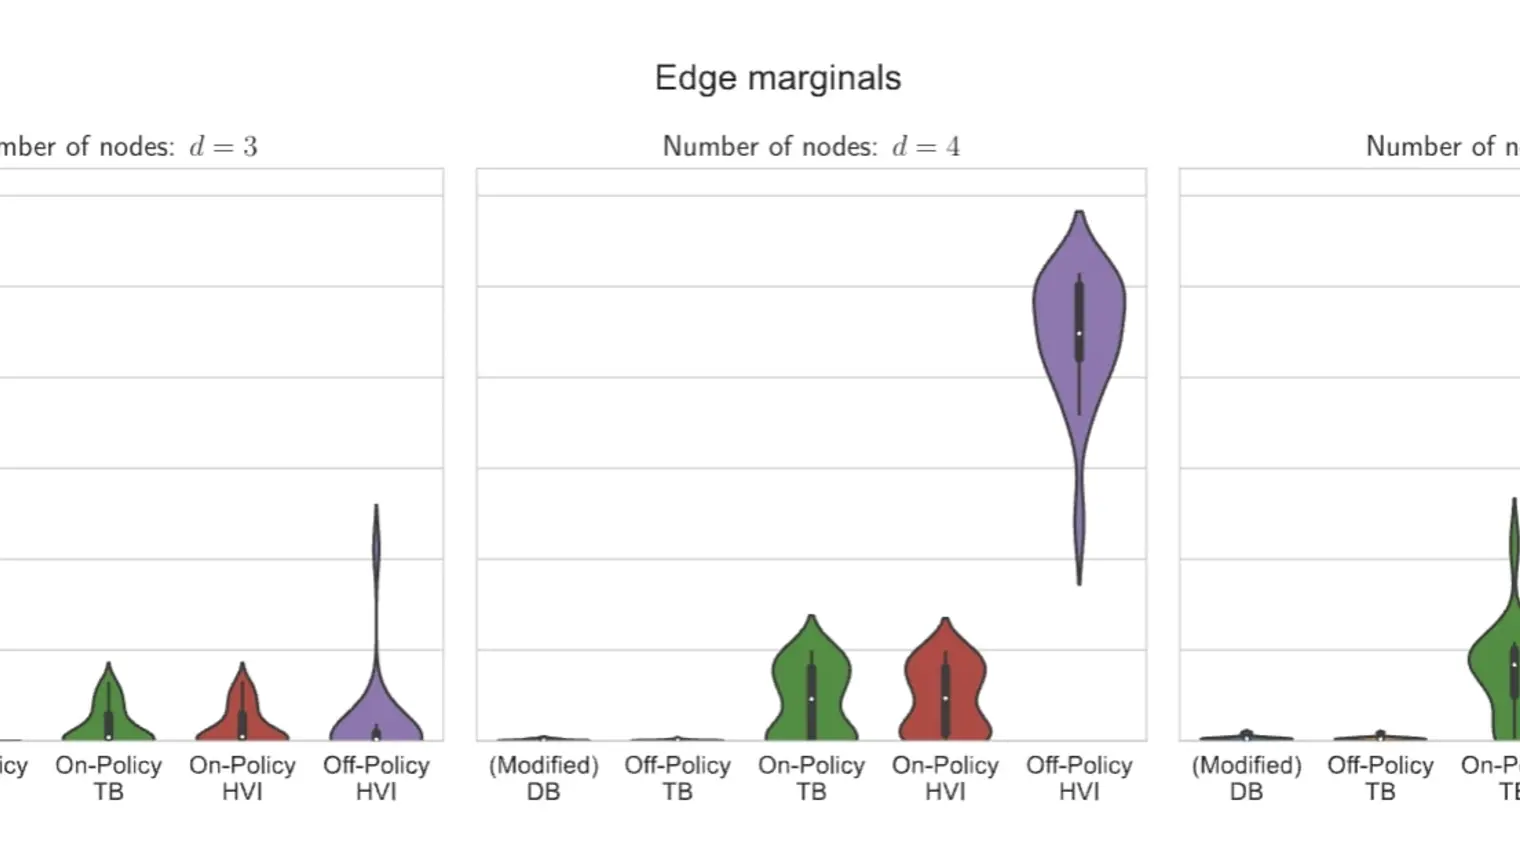
This paper builds bridges between two families of probabilistic algorithms: (hierarchical) variational inference (VI), which is typically us… (voir plus)ed to model distributions over continuous spaces, and generative flow networks (GFlowNets), which have been used for distributions over discrete structures such as graphs. We demonstrate that, in certain cases, VI algorithms are equivalent to special cases of GFlowNets in the sense of equality of expected gradients of their learning objectives. We then point out the differences between the two families and show how these differences emerge experimentally. Notably, GFlowNets, which borrow ideas from reinforcement learning, are more amenable than VI to off-policy training without the cost of high gradient variance induced by importance sampling. We argue that this property of GFlowNets can provide advantages for capturing diversity in multimodal target distributions.
2023-04-30
International Conference on Learning Representations (Accept: poster)